JUNTE-SE A MILHARES DE PESSOAS
Entre para nossa lista e receba conteúdos exclusivos e com prioridade.
Entre para nossa lista e receba conteúdos exclusivos e com prioridade.
O que é engenharia de confiabilidade e como implantar: RCM, FMEA, MTBF, OEE, preditiva e IoT conectados à excelência operacional e à redução de custos.
Resposta Direta: Engenharia de confiabilidade é a disciplina que estuda a probabilidade de um sistema, componente ou produto desempenhar suas funções sem falhas, por um período determinado e sob condições de operação específicas. Ela conecta estatística (Weibull, MTBF, MTTR), métodos de análise (FMEA, RCM, análise de causa raiz) e tecnologia (IoT, monitoramento em tempo real) para prevenir falhas antes que aconteçam — transformando disponibilidade de ativos em vantagem competitiva mensurável.
| Conceito | Definição em uma linha |
|---|---|
| Confiabilidade | Probabilidade de o ativo desempenhar sua função sem falha, por um período, sob condições especificadas |
| Disponibilidade | Fração do tempo em que o ativo está apto a operar: MTBF ÷ (MTBF + MTTR) |
| Mantenabilidade | Fração do tempo em que o ativo está apto a operar: MTBF ÷ (MTBF + MTTR) |
| MTBF | Tempo médio entre falhas — indicador de operação sem falhas |
| MTTR | Tempo médio para reparo — indicador de mantenabilidade |
| RCM | Método que define a estratégia de manutenção por função e criticidade |
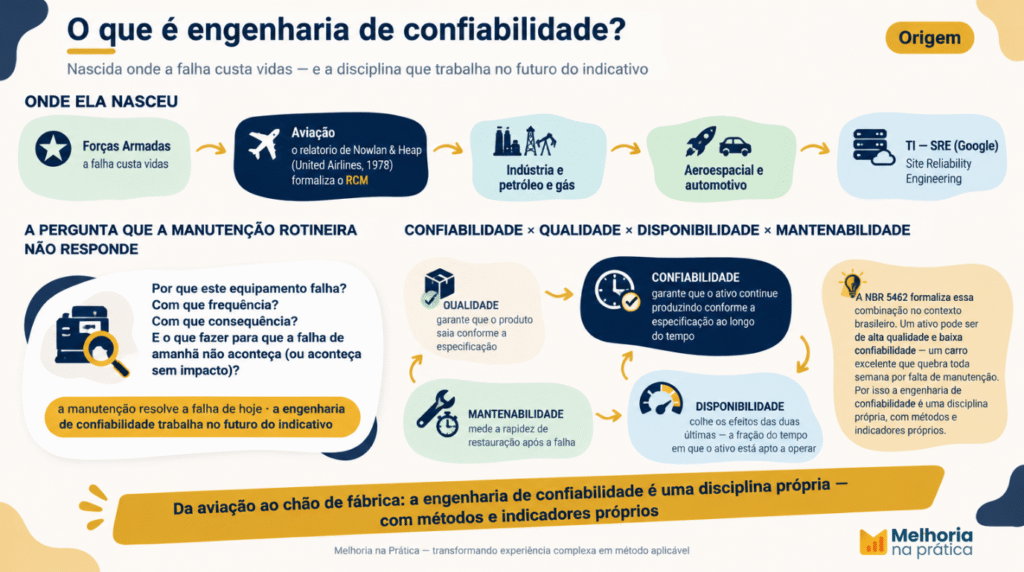
A engenharia de confiabilidade nasceu onde a falha custa vidas: nas forças armadas e na aviação. O relatório de Nowlan & Heap (United Airlines, 1978) formalizou o que hoje chamamos de RCM — e a lógica se espalhou para a indústria, o petróleo e gás, o setor aeroespacial, o automotivo e, mais recentemente, a tecnologia da informação (o SRE — Site Reliability Engineering, popularizado pelo Google).
No chão de fábrica, a disciplina responde a uma pergunta que a manutenção rotineira não responde: por que este equipamento falha, com que frequência, com que consequência — e o que fazer para que a falha de amanhã não aconteça (ou aconteça sem impacto)? Enquanto a manutenção resolve a falha de hoje, a disciplina trabalha no futuro do indicativo.
Os quatro conceitos se confundem na prática — e a confusão custa dinheiro. A qualidade garante que o produto saia conforme a especificação; a confiabilidade garante que o ativo continue produzindo conforme a especificação ao longo do tempo; a mantenabilidade mede a rapidez de restauração; e a disponibilidade colhe os efeitos das duas últimas. A NBR 5462 formaliza essa combinação no contexto brasileiro. Um ativo pode ser de alta qualidade e baixa confiabilidade (um carro excelente que quebra toda semana por falta de manutenção) — e é por isso que ela é uma disciplina própria, com métodos e indicadores próprios.
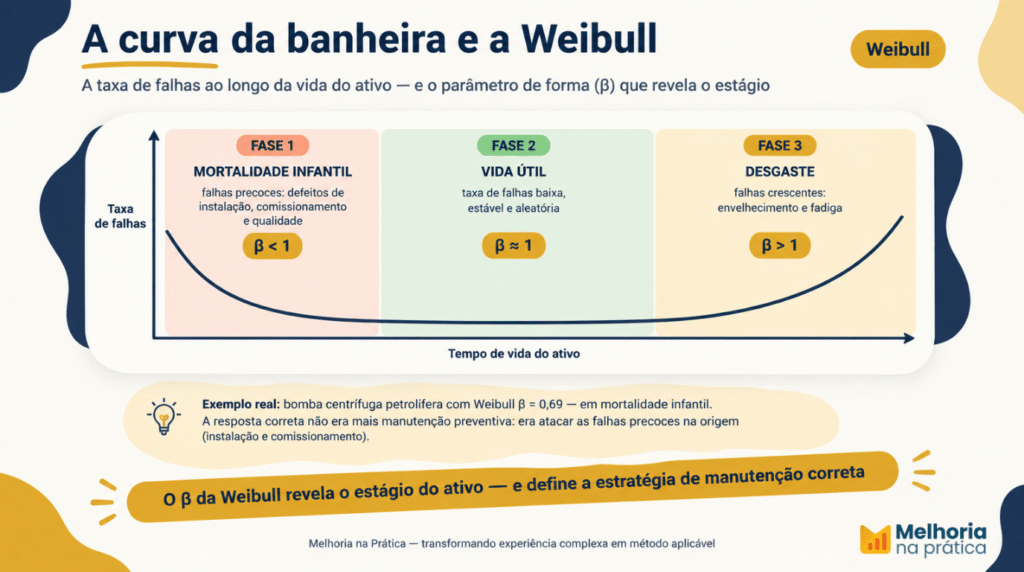
A taxa de falhas de um ativo ao longo da vida segue o padrão clássico da curva da banheira: falhas precoces no início (mortalidade infantil), período de vida útil com taxa baixa e estável, e desgaste acelerado no fim. A distribuição de Weibull modela esse comportamento a partir de dados históricos de falha — e o parâmetro de forma (β) revela em que estágio o ativo está: β < 1 indica mortalidade infantil; β ≈ 1, falhas aleatórias; β > 1, desgaste.
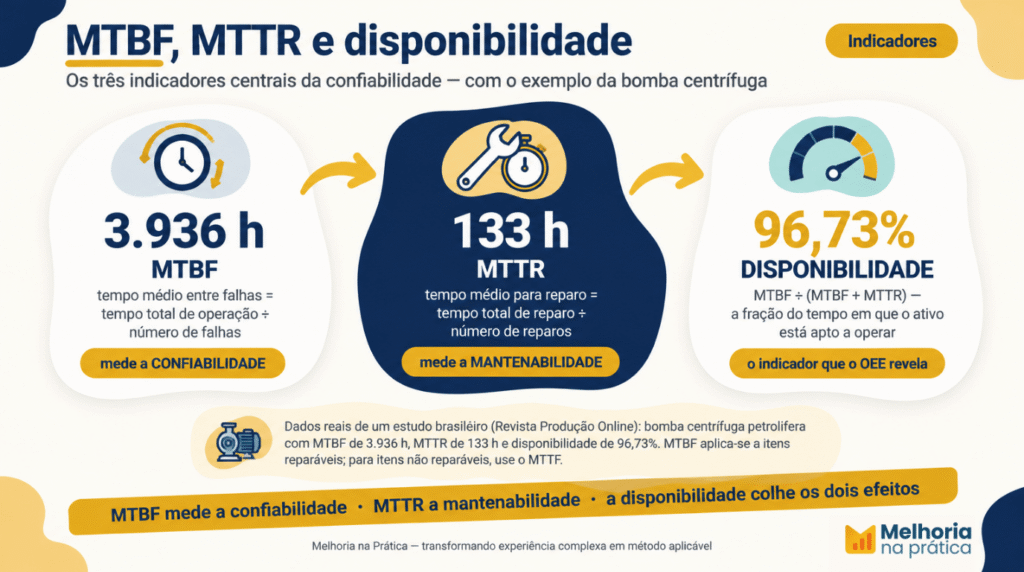
Exemplo real brasileiro: um estudo publicado na Revista Produção Online analisou uma bomba centrífuga petrolífera e encontrou MTBF de 3.936 horas, MTTR de 133 horas e disponibilidade de 96,73% — com Weibull β = 0,69, indicando que a bomba estava em fase de mortalidade infantil. A conclusão prática: investir em manutenção preventiva agressiva naquele estágio seria desperdício; o correto era atacar as falhas precoces na origem (qualidade de instalação e comissionamento).
Na lógica dos custos da qualidade, a falha não programada é o item mais caro do balanço: parada de produção, retrabalho, horas extras, expedição urgente de peças, penalidades contratuais e — nos piores casos — acidentes. A disciplina desloca o gasto da categoria falha (corretiva emergencial) para a categoria prevenção (RCM, preditiva, padronização) — e cada real investido em prevenção evita múltiplos reais em falha. É a mesma lógica do FMEA: as falhas mais baratas de corrigir são as que nunca acontecem.
Cada real investido em prevenção — um FMEA bem feito, um plano RCM, um sensor de vibração — evita múltiplos reais em falha. Ela é, na prática, o braço técnico da prevenção nos custos da qualidade: ela decide onde o investimento em prevenção gera o maior retorno.
Para Slack & Lewis, a confiabilidade é um dos cinco objetivos de desempenho (junto com qualidade, velocidade, flexibilidade e custo) e significa “entregar no prazo prometido”. Uma operação com ativos disponíveis cumpre OTIF, protege contratos e sustenta a reputação — a disponibilidade deixa de ser indicador de manutenção e vira argumento comercial. É por isso que ela é estratégia de diferenciação, não centro de custo.
A disciplina fala em números — e os centrais são três.
O MTBF (Mean Time Between Failures) mede o tempo médio de operação entre duas falhas consecutivas:
Exemplo: um equipamento operou 1.000 horas e falhou 3 vezes → MTBF = 333,3 horas. Atenção à pegadinha clássica: o MTBF se aplica a itens reparáveis; para itens não reparáveis, o indicador é o MTTF (Mean Time To Failure).
O MTTR (Mean Time To Repair) mede o tempo médio para devolver o ativo à operação:
O MTTR inclui diagnóstico, acesso físico, espera de peça e teste — não apenas o “conserto” em si. Por isso a mantenabilidade depende do projeto: acesso ao ponto de falha, padronização de componentes e procedimento documentado (POP) reduzem o MTTR antes de qualquer esforço da equipe.
A disponibilidade combina os dois:
Com o exemplo da bomba centrífuga: 3.936 ÷ (3.936 + 133) = 96,73%. No OEE, a disponibilidade é um dos três fatores — e é exatamente por isso que a disciplina e o OEE são faces da mesma moeda: o OEE revela a perda; a análise de causa explica e corrige.
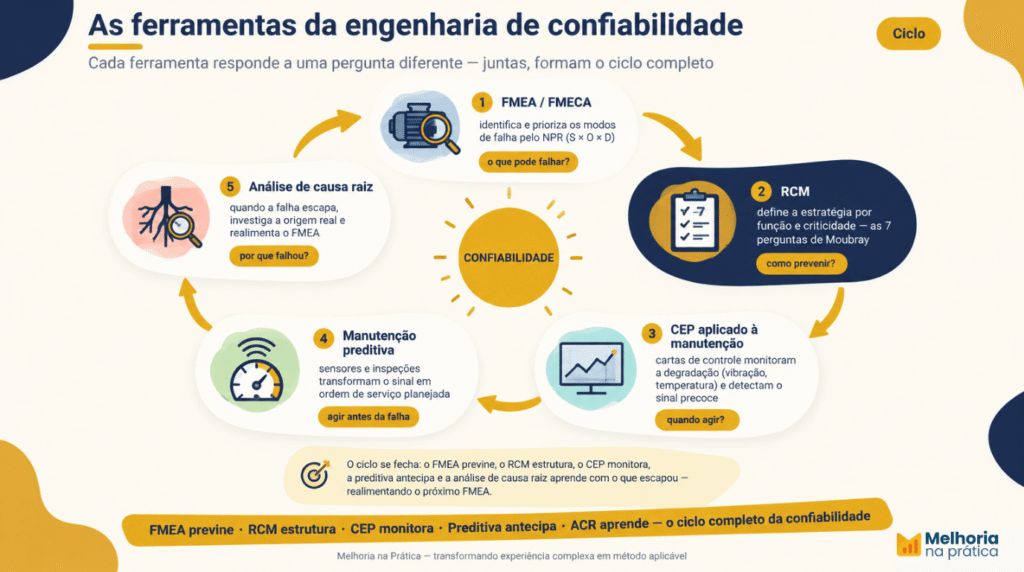
O RCM, sistematizado por John Moubray em RCM II, é um processo estruturado que parte das funções do ativo (não da lista de tarefas) e percorre sete perguntas: qual a função e o padrão de desempenho? Como a função é perdida (falha funcional)? O que causa cada falha? O que acontece quando ocorre? Em que grau cada falha importa? O que pode ser feito para prever ou prevenir? O que fazer se nada funcionar? O resultado é um plano de manutenção justificado tarefa a tarefa — preventiva, preditiva, detectiva, redesign ou até aceitar a falha, quando o custo de preveni-la supera o custo de corrigi-la.
| Estratégia | Quando usar | Exemplo |
|---|---|---|
| Preventiva por tempo | falha por desgaste com idade previsível | troca de filtro, lubrificação |
| Preditiva (condição) | degradação detectável antes da falha | análise de vibração, termografia |
| Detectiva (falha oculta) | proteções e sistemas de segurança | teste periódico de válvula de alívio |
| Redesign/modificação | consequência intolerável sem tarefa eficaz | mudança de material ou projeto |
| Corretiva aceita | consequência baixa e custo de prevenção maior | lâmpada em área não crítica |
O FMEA — em especial a variante FMECA, com criticidade — é a base da análise de confiabilidade: identifica os modos de falha com maior impacto na missão e na segurança, prioriza pelo NPR (Severidade × Ocorrência × Detecção) e orienta planos de manutenção, estoque de peças críticas e controles. É a técnica catalogada pela IEC 60812 e pela ISO 31010 para análise de falhas técnicas..
Nenhuma disciplina elimina 100% das falhas. Quando a quebra acontece, a análise de causa raiz (ACR) investiga a origem real — não o sintoma — para impedir a recorrência. O ciclo se fecha: o FMEA previne, a ACR aprende com o que escapou, e o aprendizado realimenta o próximo FMEA.
As cartas de controle — tradicionalmente associadas à qualidade de processo — têm papel subestimado na gestão de ativos: monitoram parâmetros de degradação (vibração, temperatura, pressão, consumo) ao longo do tempo e separam a variação natural do sinal precoce de falha. É a base estatística da manutenção preditiva: a carta detecta a tendência antes do ponto sair do controle — e a ordem de serviço nasce da dados, não da queixa.
A análise de Weibull transforma o histórico de falhas em uma distribuição que revela a fase de vida do ativo (via parâmetro β) e projeta o comportamento futuro — base para definir intervalos de preventiva e estimar custos de garantia. Quando não há histórico — produto novo ou componente de vida longa —, os testes acelerados (ALT) induzem a falha sob cargas intensificadas; o HALT, usado em desenvolvimento, expõe fraquezas de projeto antes da produção em série.
Antes de implantar, é preciso saber onde a operação está. Três modelos se complementam:
Maturidade da gestão de manutenção (evolução das estratégias):
| Nível | Estratégia dominante | Sinal típico |
|---|---|---|
| 1 — Reativo | Corretiva emergencial | “Apaga incêndio”; paradas não programadas dominam |
| 2 — Preventivo | Manutenção por calendário | Planos existem, mas sem base em dados de falha |
| 3 — Preditivo | Monitoramento de condição | Sensores e inspeções detectam degradação antes da falha |
| 4 — Proativo (RCM) | Estratégia por função e criticidade | Plano justificado tarefa a tarefa; FMEA vivo |
| 5 — Integrado | Gestão de ativos (ISO 55000) | Ativos conectados à estratégia e ao ciclo de vida |
Maturidade da gestão de ativos (ISO 55000): a norma internacional avalia o alinhamento dos ativos aos objetivos da organização — liderança, política, objetivos, planos, riscos do ciclo de vida e melhoria contínua. É o nível em que a gestão de ativos deixa de ser função da manutenção e vira sistema.
Autoavaliação prática: responda para cada ativo crítico — existe registro de falha confiável? Existe FMEA atualizado? A estratégia de manutenção é justificada por dados? O indicador de disponibilidade é acompanhado pela liderança? Quatro “nãos” posicionam a operação no nível 1–2; quatro “sims”, no 4–5.
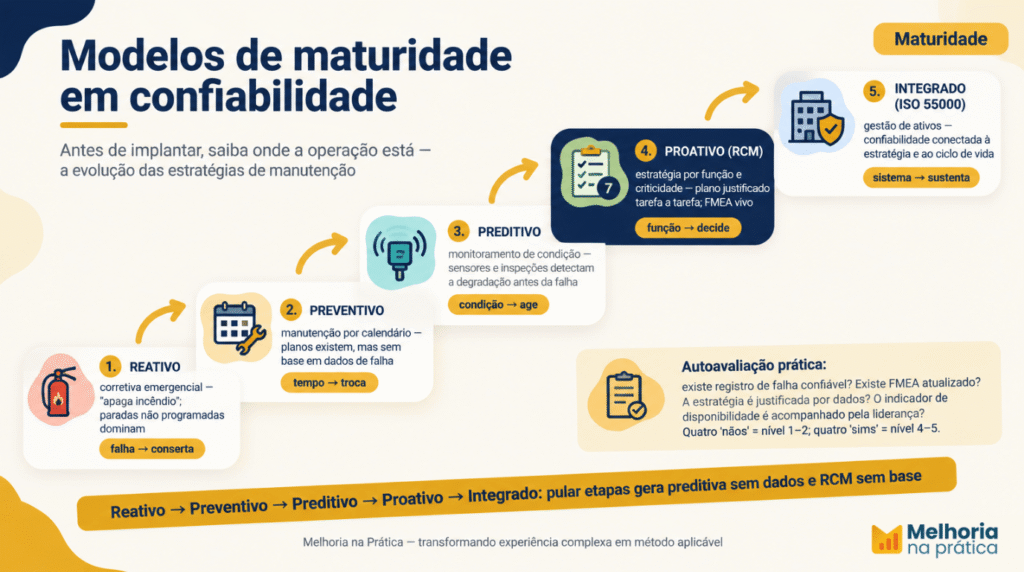
A evolução das estratégias de manutenção segue uma lógica de antecipação: a corretiva reage à falha; a preventiva antecipa por tempo; a preditiva antecipa por condição; a proativa elimina a causa. Cada passo à esquerda dessa sequência reduz o custo da falha — e aumenta a exigência de dados.
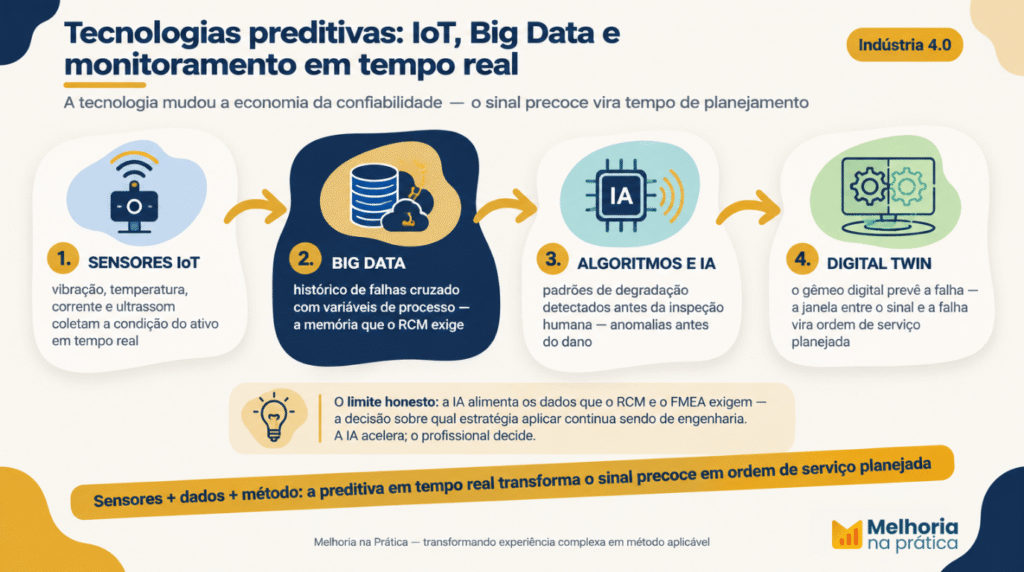
A evolução tecnológica mudou a economia da confiabilidade. Sensores IoT (vibração, temperatura, corrente, ultrassom) coletam a condição do ativo em tempo real; o Big Data armazena e cruza o histórico de falhas com variáveis de processo; e os algoritmos detectam padrões de degradação que a inspeção humana não percebe. O resultado prático: a janela entre o sinal precoce e a falha funcional — antes desperdiçada — vira tempo de planejamento.
Na prática, isso significa que a manutenção passa de reativa para preditiva em tempo real: anomalias são detectadas antes de causar dano, e o digital twin prevê a falha antes que ela aconteça. Mas a tecnologia não substitui o método: a IA alimenta os dados que o RCM e o FMEA exigem — a decisão sobre qual estratégia aplicar continua sendo de engenharia. É a mesma tese dos artigos de resolução de problemas com IA e de excelência operacional: a IA acelera; o profissional decide.
No sistema de excelência operacional, a confiabilidade ocupa o núcleo operacional ao lado da TPM: sem ativo disponível e confiável, o Lean perde a fundação e a melhoria não se consolida. As conexões são diretas:
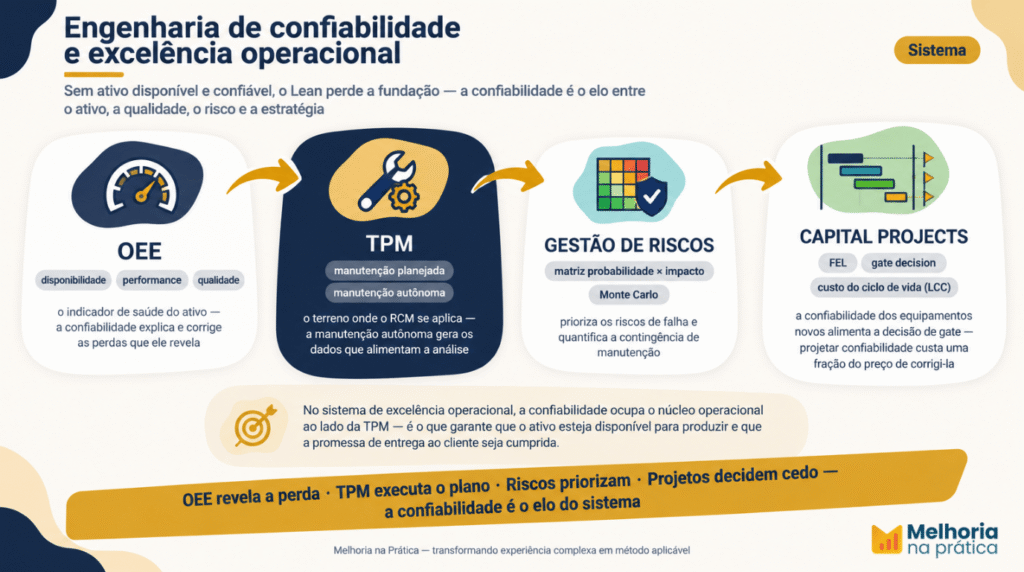
O engenheiro de confiabilidade normalmente vem de Engenharia de Produção, Mecânica ou Elétrica, com especialização na área. No Brasil, há pós-graduações dedicadas: a PUC Minas oferece Engenharia de Confiabilidade e Gestão de Ativos em formato EAD com aulas ao vivo; a UTFPR mantém programa em Curitiba; e o SENAI CIMATEC também oferece especialização na área.
Referências de mercado apontam salários iniciais na faixa de R$ 7 mil, com progressão conforme experiência, certificações e setor — valores que variam por região, porte e segmento e devem ser confirmados em pesquisas salariais atualizadas antes de usar como âncora de negociação. Para quem quer construir a base de método que sustenta a carreira, o guia de carreira em projetos e melhoria contínua mostra o roadmap completo.
Estuda a probabilidade de falha dos ativos, aplica FMEA/RCM para definir estratégias de manutenção, acompanha indicadores (MTBF, MTTR, disponibilidade) e lidera a análise de causa raiz das falhas — prevenindo paradas antes que aconteçam.
A manutenção resolve a falha de hoje; a disciplina de confiabilidade trabalha para que a falha de amanhã não aconteça — ou aconteça sem consequência. Uma executa; a outra projeta a estratégia
RCM (Manutenção Centrada na Confiabilidade) é o processo que define a política de manutenção a partir das funções do ativo e das consequências das falhas — seguindo as 7 perguntas de Moubray. Aplique nos ativos críticos, com FMEA como base de análise.
MTBF = tempo total de operação ÷ número de falhas no período. MTTR = tempo total de reparo ÷ número de reparos. Disponibilidade = MTBF ÷ (MTBF + MTTR). Exemplo: 1.000h de operação com 3 falhas → MTBF de 333,3h.
Qualidade verifica a conformidade no momento da entrega; confiabilidade projeta o desempenho ao longo do tempo. Um produto pode ser 100% conforme hoje e falhar em 30 dias. As duas disciplinas compartilham ferramentas (FMEA, CEP, análise de causa raiz), mas respondem a perguntas diferentes.
É o padrão clássico de taxa de falhas ao longo da vida do ativo: mortalidade infantil (falhas precoces, taxa decrescente), vida útil (falhas aleatórias, taxa constante) e desgaste (taxa crescente). A distribuição de Weibull identifica a fase pelo parâmetro de forma β — e a fase define a estratégia de manutenção adequada.
O salário inicial gira em torno de R$ 7.000 no Brasil, com progressão expressiva em setores de alta criticidade como petróleo e gás, mineração e energia.
O FMECA acrescenta a criticidade à análise — quantifica o impacto da falha na missão, além de severidade, ocorrência e detecção. É a variante usada na análise de confiabilidade de ativos.
A engenharia de confiabilidade existe para garantir exatamente isso: transformar dados de falha em previsão, previsão em estratégia e estratégia em disponibilidade sustentada. Ela não substitui a manutenção — a dirige. E, integrada ao sistema de excelência operacional, deixa de ser assunto técnico de manutenção para se tornar o que sempre foi nas indústrias de alta exigência: uma estratégia de diferenciação.
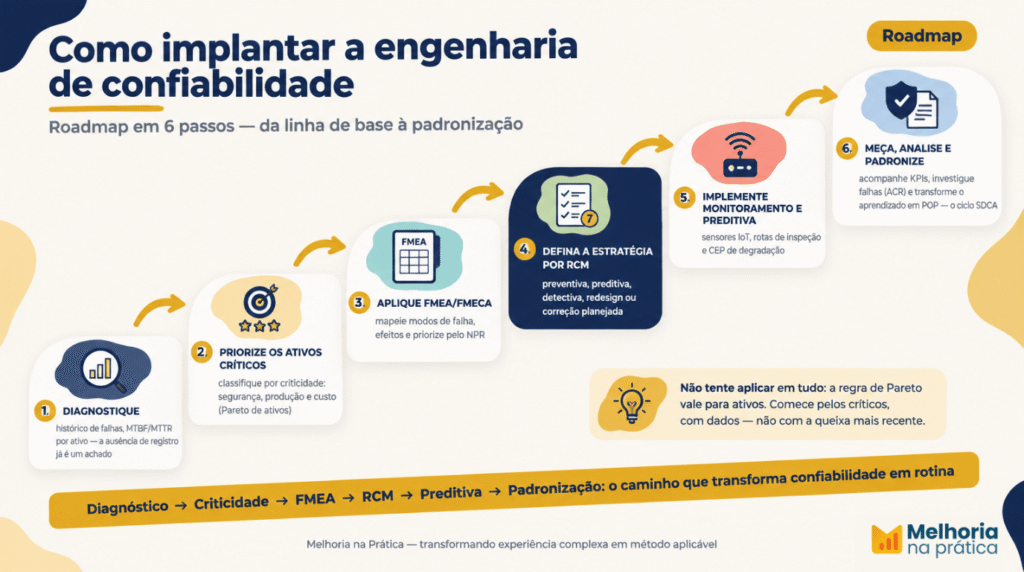
Comece simples: escolha os ativos críticos, calcule o MTBF e a disponibilidade, aplique o FMEA nos modos de falha de maior risco e defina a estratégia por RCM. Quando a análise vira rotina — com causa raiz investigada e ganho padronizado —, a confiabilidade deixa de ser indicador e passa a ser a memória operacional que impede o mesmo problema de voltar duas vezes.
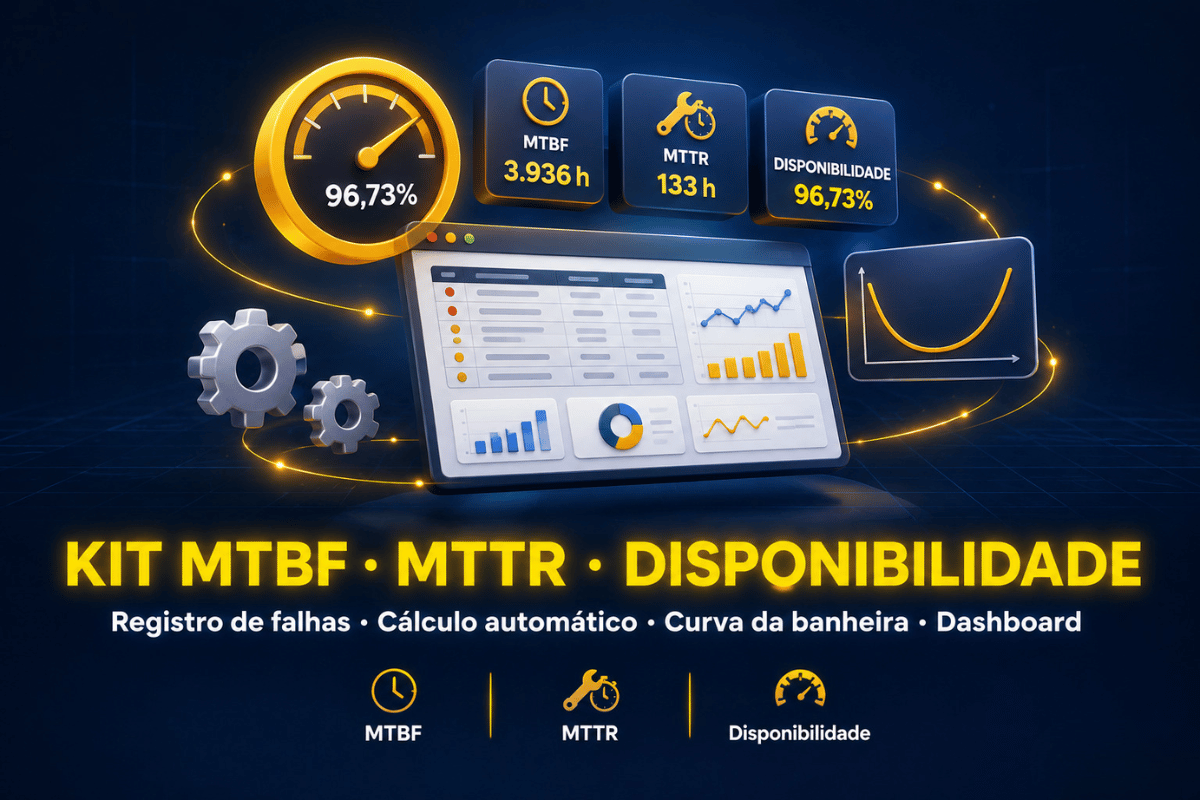
📥 Baixe o Kit de Cálculo de MTBF, MTTR e Disponibilidade — planilha com fórmulas automáticas, curva da banheira e dashboard de indicadores.
Materiais para download
Kit de Cálculo de MTBF, MTTR e Disponibilidade